池化技术
我们对于一个批量操作,例如 批量暂停账户 或者是 批量删除数据
我们很常规的做法就是 接口开放 []business_list 然后通过 for 进行处理对应的对应的业务逻辑
|
|
但是这种在数据量大的时候会有一个问题 那么就是 前端等待超时, 这个超时 我上班的时候看着是 nginx还是前端那边特定组件控制的
这时候可能就会想到
-
我们只提交
tasks然后放入到数据库中,单独开启一个go backend_job进行处理,并且处理对应的状态流转。 这种思路在我们 批量处理数据的地方屡见不鲜- 这里就需要考虑 状态的流转,展示
- 如果进程重启,还需要恢复
- 如果数据量很大很大,是不是要考虑 分批分次进行,还需要进度控制
-
使用
long-task接口,前端发起req请求,后端返回一个task-id然后每次都适用task-id进行请求 查看任务状态 。- 这种做法,我能想到的问题就是,用户会被硬控在前端页面一直
loading
- 这种做法,我能想到的问题就是,用户会被硬控在前端页面一直
池化技术貌似并不能很好的解决 第一个方案,如果数据量真的很大很大,感觉还是要进行分批分次进行 ,并且加上进度控制 。 顶多优化一下每轮的次数
更多的是优化第二个内容,优化接口的响应和返回
|
|
突然想起来了 :
- 这里的池化技术 特指
并发池而不是连接池对于 连接池的技术不熟悉
GMP
现在我是一个小白, 例如如果我们要实现 清理 100w条数据 那么是否是 开 100w 个 gorutine 更好呢,毕竟每一个 gourtine 单独处理最快
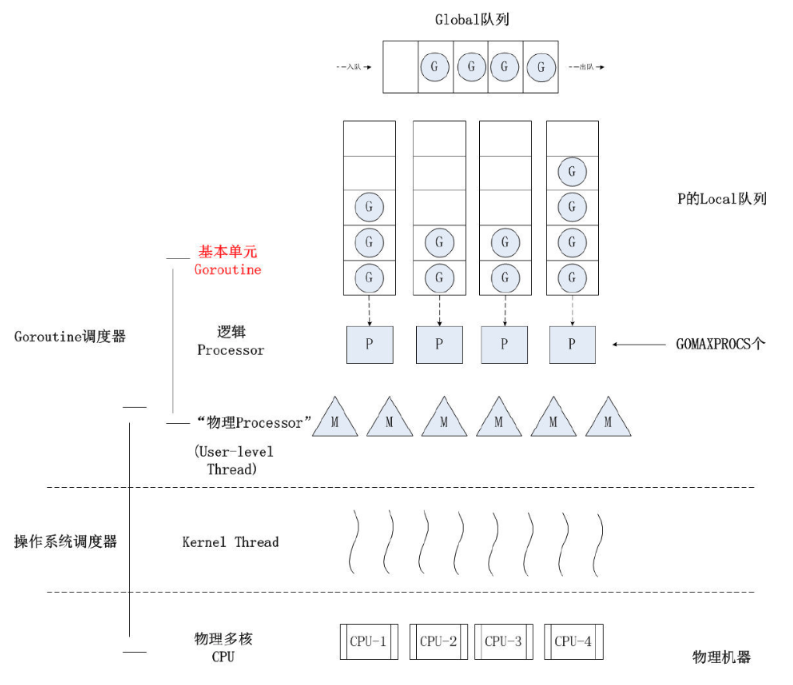
我么可以从 GMP设计图 中很直观的看到
-
全局队列 : 存放等待运行的
G -
P的本地队列 : 存放的也是等待运行的
G。 本地队列的限制是256 -
P列表 : 可以认为是 逻辑上的 CPU . 数量可以认为是 CPU 的核数
-
M : 线程 ; 想要运行任务就需要获取
P. 并且通过内核线程Kernel Thread进行CPU的相关调度请求
一些调度关系 :
-
如果 当前
M绑定的P的G阻塞了,那么会重新调度一个新的M进行后续G的运行 -
G如果运行完之后 会产生对应的GC占用一定的内存空间 -
如果当前本地队列
P没有可运行的G, 那么会去全局队列进行寻找 -
如果 当前本地队列
P没有可运行的G并且 全局队列为空 ,那么会去其他队列进行偷取 . (降低性能)
大量创建 go 协程的代价
内存开销:
-
初始阶段 goroutine 大概只有
2k的内存开销 . ps : 一个线程 大概需要2M的开销/go/pkg/mod/golang.org/toolchain@v0.0.1-go1.23.4.darwin-arm64/src/runtime/runtime2.go:422
调度开销:
-
我们可以从上面的图中看到 ,一个
G需要先放到全局队列,然后到本地队列,最后到P又需要根据M进行绑定最后跑到内核线程 。 -
并且一个很坏的结果是,当我们的
G阻塞后,会创建新的M来进行执行,导致内核的线程开销也会变大
gc开销:
- 协程占用的内存最终需要 Gc 来回收
协程池
我们知道
- 并发可以提高处理请求的速度
- 但是并发数量并不是越多越好
这是一个 规则怪谈 ,所以这时候 引入了 协程池,即固定数量的协程
- 例如
nginx最多支持 每秒钟并发5个请求,那么我们就可以启动一个数量为5的协程池进行批量工作
实现 1
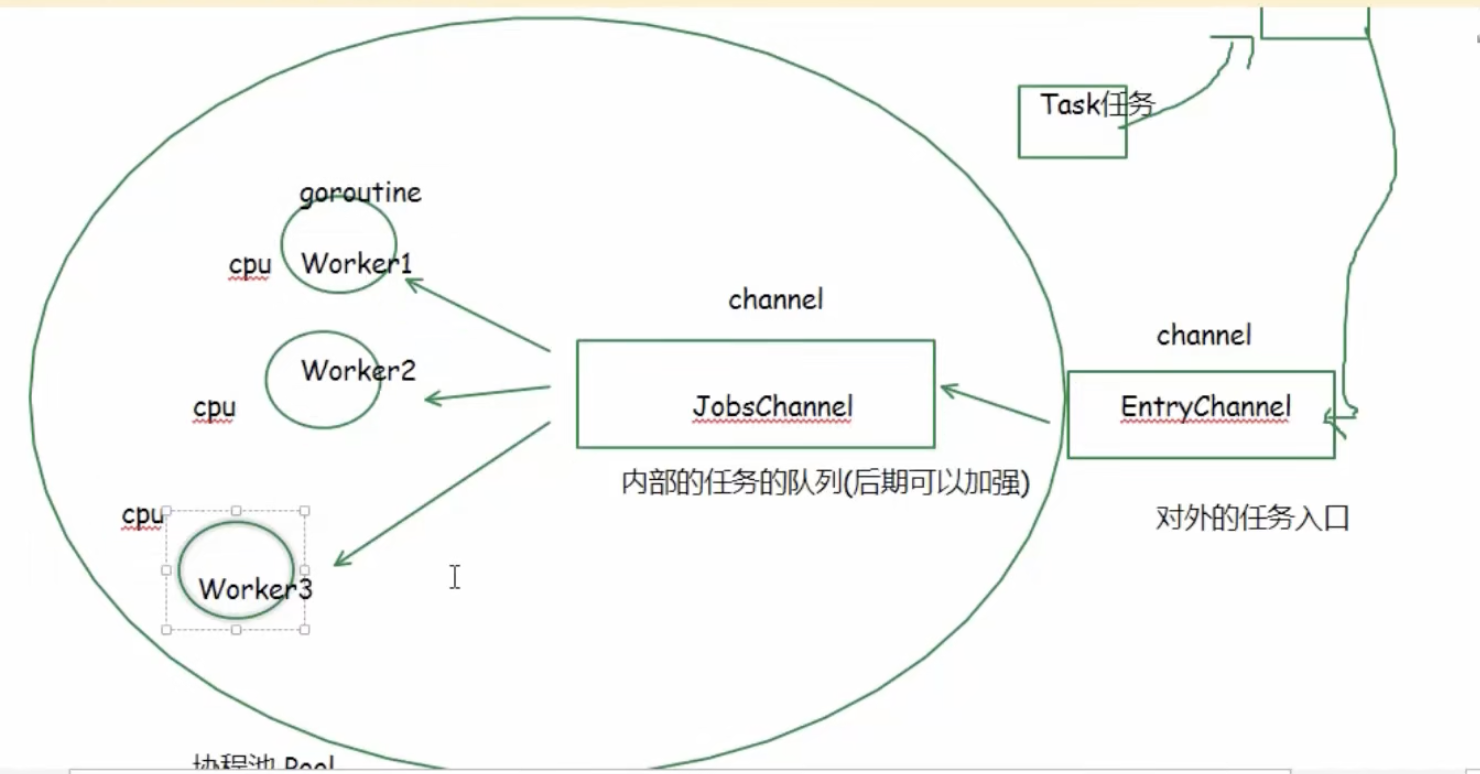
架构
-
work实际运行的gourtine用于并发处理func() -
JobsChannel内部任务的队列用于分发任务到work()中 -
EntryChannel对外处理任务的队列,用于对接JobsChannel的数据
代码剖析
Task
定义 Task 其中值字段包含一个 func value()
并且支持一个函数用于执行 Execute()
|
|
Pool
整个 pool 定义如下
|
|
支持的 Func 如下
单独解释一下 Run 过程
-
这里先通过 遍历
workerNum启动gourtine -
启动之后会进入到
JobsChannel此时数据里面没有,会进行阻塞
然后下方的数据会进行获取数据并且传入
|
|
完整运行
|
|